
Mein eigenes Second Brain

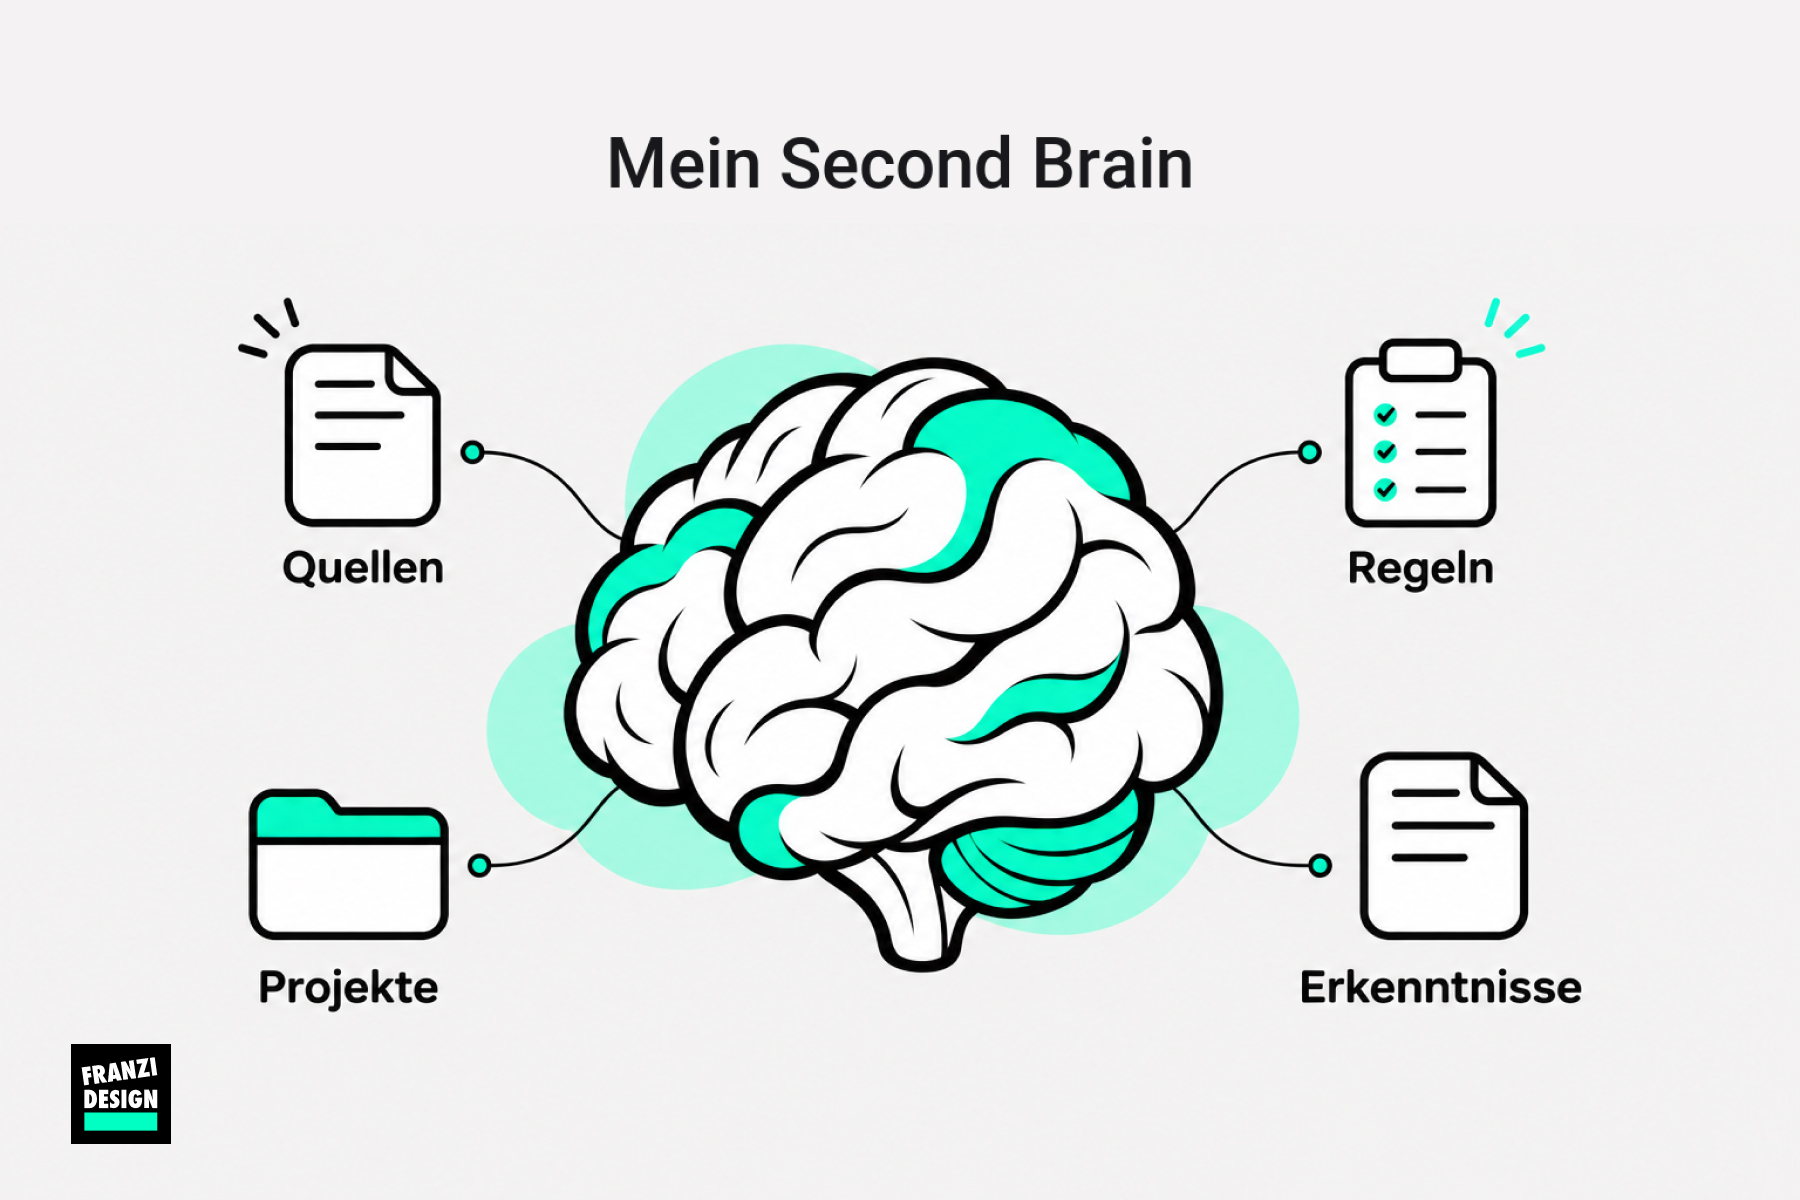
Drei Situationen aus meinem Alltag haben mich dazu gebracht, ein eigenes Second Brain aufzubauen:
- Im Studium verliere ich mich schnell in der Recherche, obwohl ich schon gute Unterlagen habe.
- Für meinen Blog liegen Notizen, Entwürfe und Bilder an verschiedenen Orten.
- Und bei der Steuererklärung wollte ich meine Unterlagen für 2026 so vorbereiten, dass ich sie mit den Vorjahren abgleichen kann.
In allen drei Fällen ging es für mich um dieselbe Frage: Wie kann ich mit dem weiterarbeiten, was ich schon gesammelt habe?
Was ist ein Second Brain?
Ein Second Brain ist ein persönliches Wissensarchiv. Darin sammle und verknüpfe ich Unterlagen, Notizen und Erkenntnisse, die ich später wiederverwenden möchte. Bei mir unterstützt die KI das Einordnen und Pflegen. Eine Startseite führt zu meinen Projekten; Links verbinden Quellen, Arbeitsregeln und daraus entstandene Erkenntnisse. Mein Archiv liegt in einem mit Google Drive synchronisierten Arbeitsordner, den ich für die Zusammenarbeit mit KI-Werkzeugen freigebe.
Mein Studium war der Ausgangspunkt
Seit Oktober studiere ich berufsbegleitend Beratung und Beratungswissenschaft bei artop an der HU in Berlin. Neben meiner Vollzeitstelle bei DATEV ist die Zeit fürs Studium begrenzt. Wenn ich mich in ein Thema einarbeite, werden aus einer Frage schnell drei. Irgendwann bin ich tief in der Recherche, obwohl ich von der Uni schon viele Unterlagen habe, auf denen ich aufbauen könnte. Deshalb habe ich Google NotebookLM ausprobiert. Ich konnte Fragen zu meinen Unterlagen stellen, zu passenden Textstellen springen und mir Inhalte als Audio anhören. Allerdings bin ich schnell an ein Nutzungslimit gestoßen. Über meine Erfahrungen mit NotebookLM habe ich bereits geschrieben: Mein Erfahrungsbericht mit NotebookLM
Gleichzeitig habe ich mich gefragt, wie viel ich selbst von den aufbereiteten Inhalten wirklich behalte. Ich wollte bewusster mit meinem Material arbeiten, gezielter entscheiden, was ich noch recherchieren muss, und mich weniger von einem einzelnen Anbieter abhängig machen. Mitte November 2026 habe ich mir an einem Wochenende die Zeit genommen und mein eigenes Second Brain aufgebaut. Bisher bin ich begeistert.
Praxisfall 1 – Meine Dateien und mein Blogarchiv
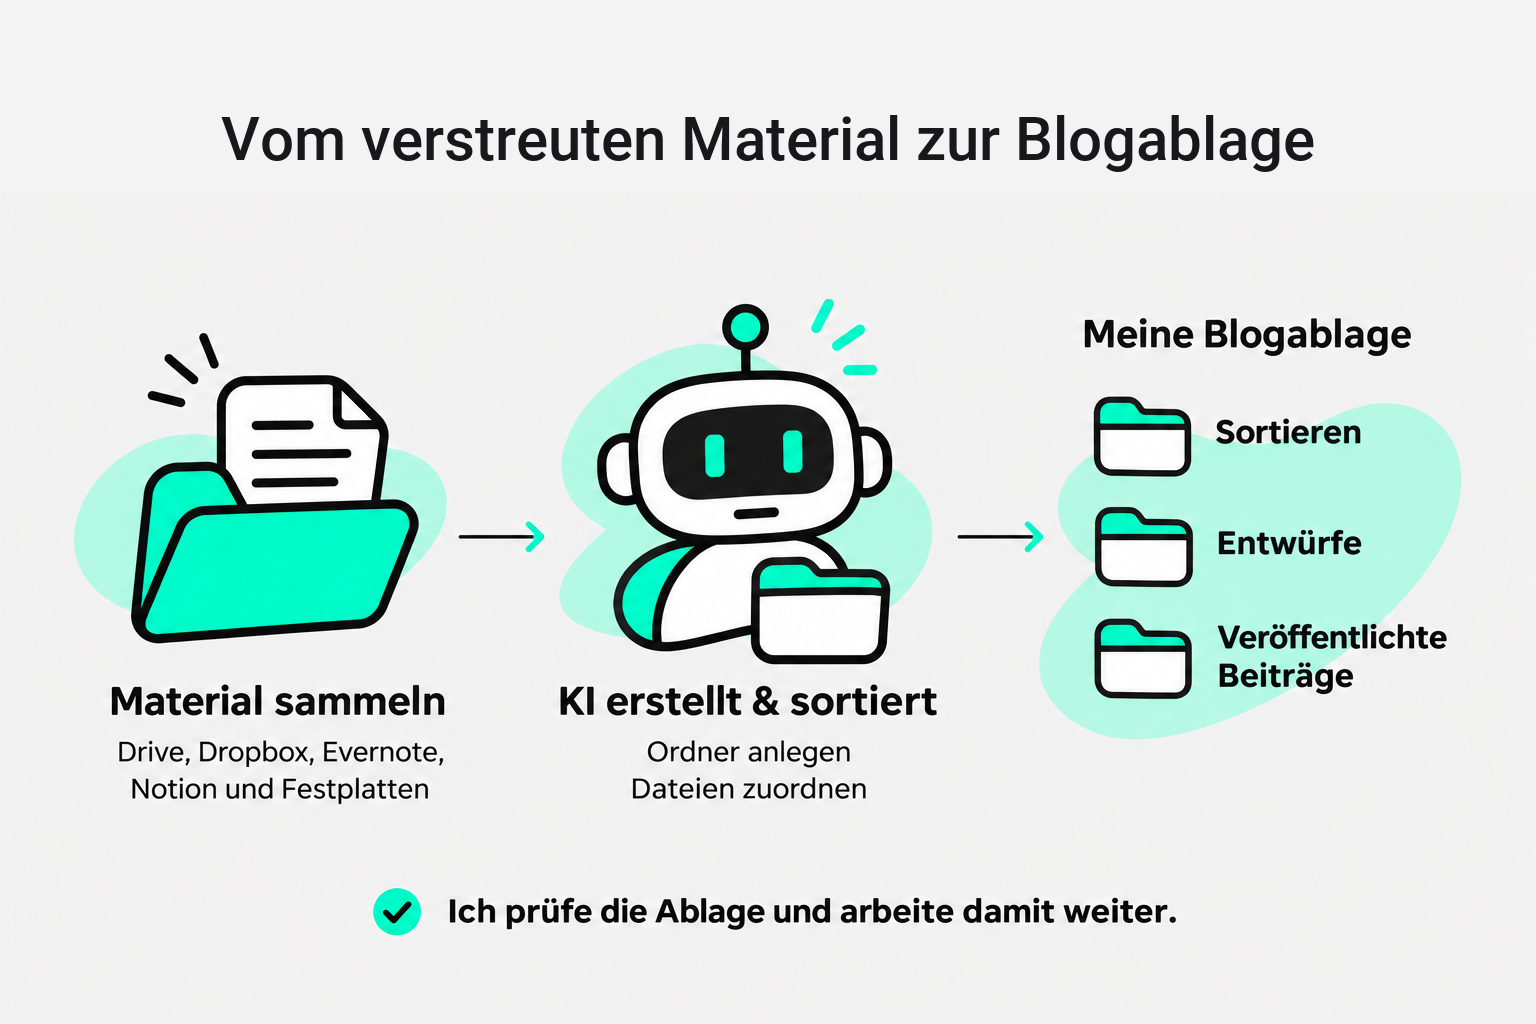
Über die Jahre habe ich sehr viele Dateien und Notizen in Google Drive, Dropbox, Evernote und Notion abgelegt. Auf meinen Festplatten liegen außerdem Kundendaten und Projektmaterial aus meiner Selbstständigkeit, manches doppelt oder dreifach. Für meinen Blog hat die KI in meinem Auftrag eine Ablage angelegt und Material einsortiert: „Sortieren“ für noch nicht eingeordnete Inhalte, „Entwürfe“ für den aktuellen Beitrag und „Veröffentlichte Beiträge“ für das Archiv samt Bildern. Auf diesen Arbeitsstand kann ich ChatGPT direkt verweisen. Ob die Zuordnung sinnvoll und vollständig ist, prüfe ich selbst. Die Bilder und Artikel von meiner Website hat die KI dabei automatisch in die passenden Ordner eingeordnet.
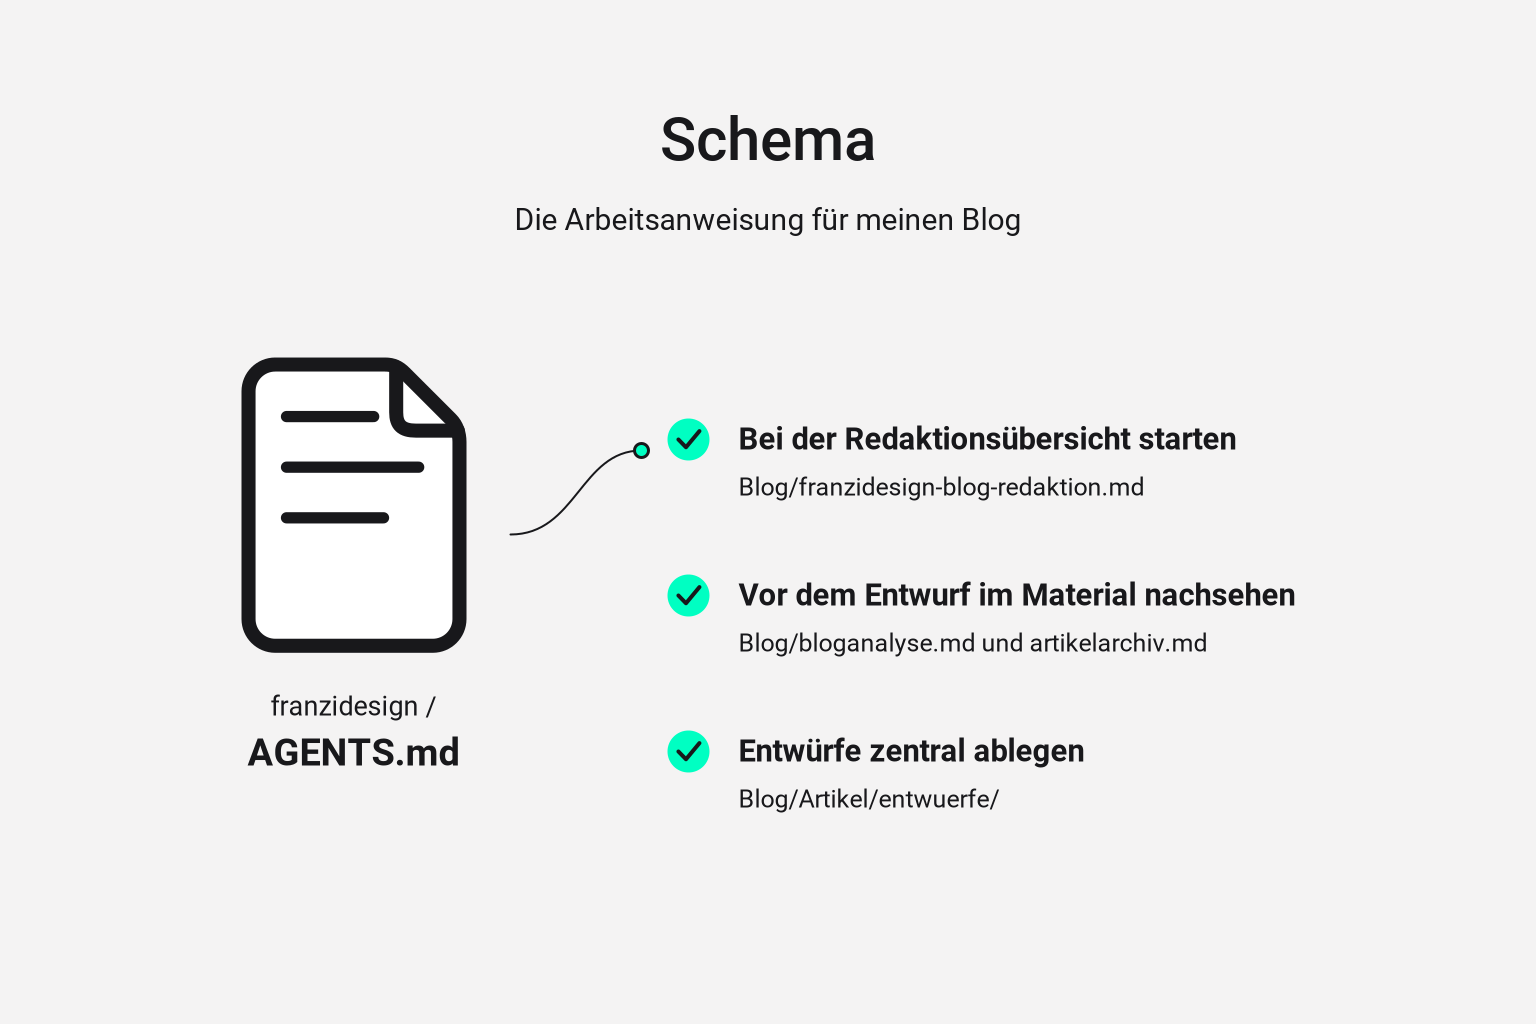
In der Datei AGENTS.md im Ordner „franzidesign“ ist festgehalten, welche Dateien die KI vor einem Blogentwurf lesen soll. Die Regeln verweisen auf die Redaktion, das Schreibprofil und das Artikelarchiv im Unterordner „Blog“. Neue Entwürfe gehören nach „Blog/Artikel/entwuerfe“. Inzwischen ist auch eine freigegebene Bildsprache für franzidesign mit Referenzgrafiken und Gestaltungsregeln hinterlegt. Darauf gehe ich am Ende des Artikels näher ein. Diese Vorgaben können beim nächsten Beitrag wieder eingelesen werden.
Für den Blog habe ich ChatGPT gebeten, die bereits öffentlich zugänglichen Beiträge meiner Website samt Bildern in Drive zu sichern. Bei Rückfragen zur Freigabe habe ich selbst entschieden, ob die jeweilige Aktion zu meinem Auftrag passt. Bei meinen eigenen Blogbeiträgen konnte ich den Umfang gut einschätzen.
Ein Ausschnitt aus der von der KI angelegten Sicherung. Im Bilderordner der Kategorie „Werbung“ enthalten die Dateinamen das Datum und den Titel des jeweiligen Beitrags. So kann ich die Bilder später einem Artikel zuordnen.
Danach bin ich die Ordner selbst noch einmal durchgegangen. Im Ordner „Jahresrückblick“ lagen nur zwei Beiträge. Weil ich mein Archiv kenne, fiel mir auf, dass es mehr sein müssten. Ich habe ChatGPT gebeten, die Zuordnung erneut mit den Kategorien meiner Website abzugleichen. Diese Nachkontrolle war hier entscheidend.
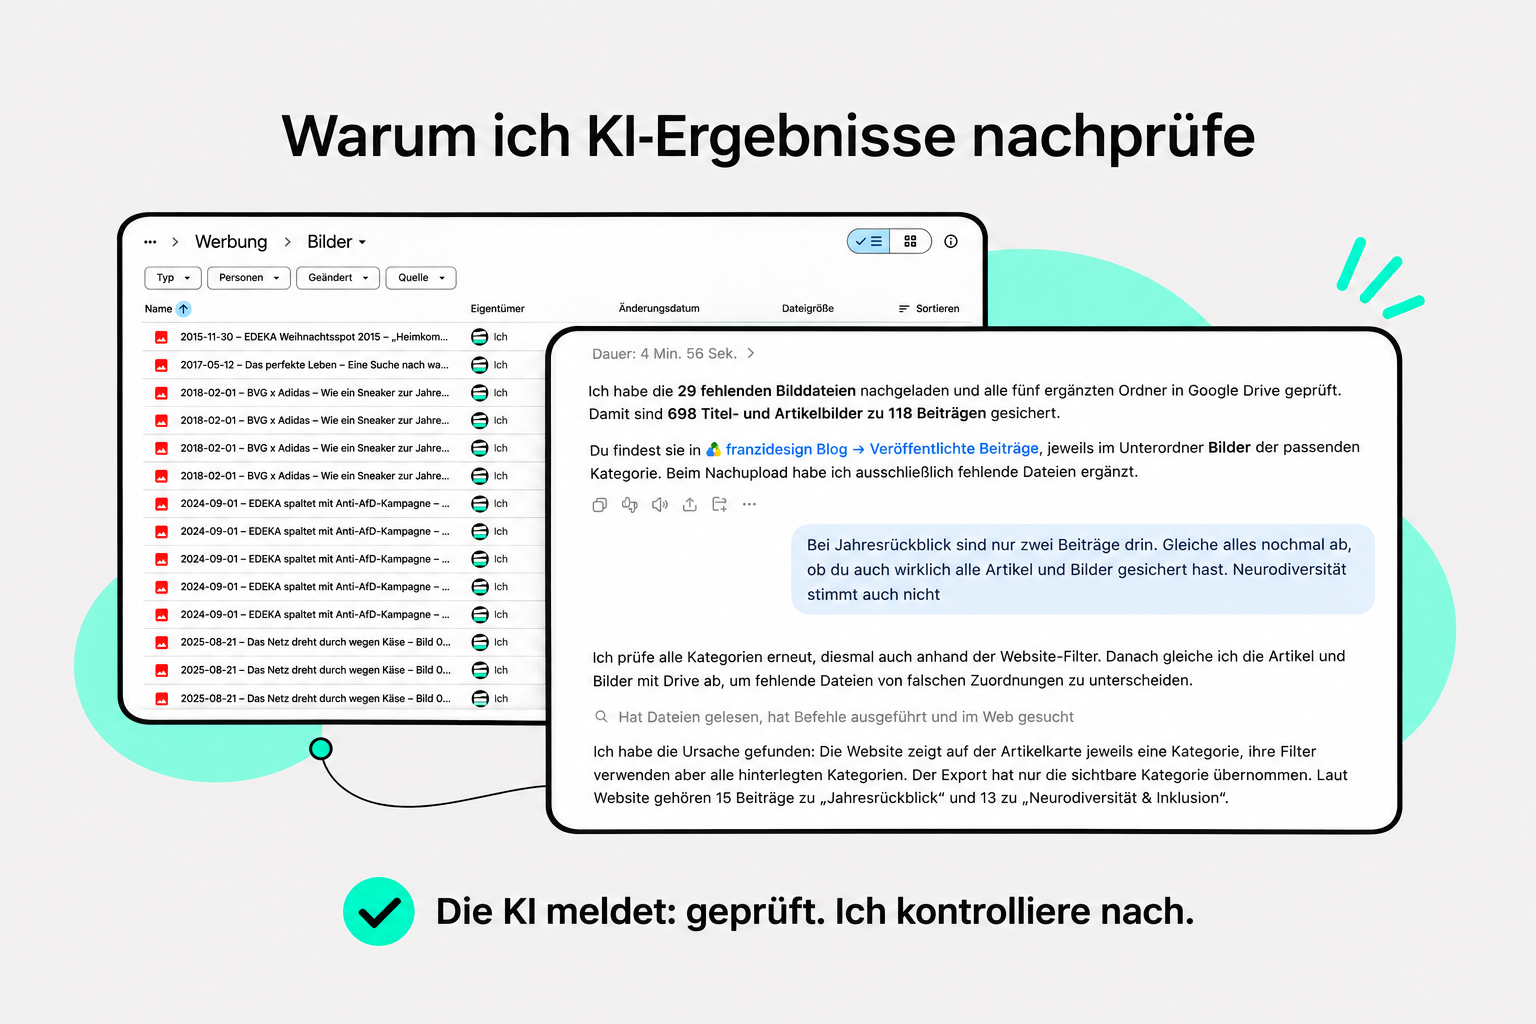
ChatGPT hatte die Sicherung bereits als geprüft gemeldet. Nach meinem Hinweis erklärte die KI, dass beim Export nur die auf den Artikelkarten sichtbare Kategorie übernommen worden war. Die Website-Filter berücksichtigen laut dieser Erklärung mehrere Kategorien pro Beitrag. Die Rückmeldung „geprüft“ hat mir hier nicht als Nachweis gereicht. Erst der Blick in die Ordner und der Abgleich mit meiner Website machten die Lücke sichtbar. Nach der Korrektur meldete ChatGPT beim damaligen Abgleich 15 Beiträge im Jahresrückblick und 13 unter „Neurodiversität & Inklusion“. Die gemeldeten Dateizahlen enthielten auch Kopien für Mehrfachzuordnungen. Beim Sichern hat mir die KI Arbeit abgenommen. Die Vollständigkeit musste ich trotzdem selbst prüfen – meine Kenntnis des Archivs war dabei entscheidend.
Praxisfall 2 – Meine Steuerunterlagen im Jahresvergleich
Mein zweiter Test mit dem Second Brain waren die Steuerunterlagen 2026. Für das aktuelle Jahr habe ich mit ChatGPT eine neue Übersicht erstellt, die ich mit den Unterlagen aus den Vorjahren abgleichen kann. Dabei habe ich auch meine bereits eingereichte Erklärung für 2025 mit KI abgleichen lassen. Die Unterlagen lagen in meinem freigegebenen Arbeitsordner auf dem Rechner. Bei den Reisekosten fehlte eine Fahrt, die mein Steuerberater und ich übersehen hatten. Außerdem fehlte die Homeoffice-Pauschale. Der Bescheid war noch nicht da, also habe ich meinem Steuerberater zu beiden Punkten geschrieben und wir haben das sofort korrigiert.
Beim nächsten Durchgang kann ich die neue Übersicht neben die Vorjahre legen und gezielt prüfen, ob alle Fahrten erfasst und die Homeoffice-Tage vollständig sind. Die dokumentierte Korrektur dient mir dabei als Ausgangspunkt. Sie hilft mir, denselben Punkt beim nächsten Mal bewusst zu prüfen.
Wie ich mein Second Brain aufgebaut habe
Für den Einstieg habe ich einen Second-Brain-Setup-Prompt verwendet, den ich bei Jonas Keil auf der Website gefunden habe. Ich habe die Ordner in meinem synchronisierten Drive-Arbeitsbereich eingerichtet und diesen für die KI freigegeben. Der Ansatz lässt sich auch mit Claude umsetzen. Entscheidend ist, dass das verwendete Werkzeug die ausgewählten Dateien lesen, anlegen und bearbeiten darf.
Die Vorlage orientiert sich am „LLM Wiki“ von Andrej Karpathy. Karpathy beschreibt ein Muster für eine verlinkte Wissensbasis; der Einrichtungs-Prompt übersetzt es in einen geführten Einstieg. Die fünf Schritte des Einrichtungs-Prompts reichen vom Kennenlernen bis zur Pflege der Ablage. Mir hat besonders geholfen, dass ChatGPT immer nur eine Frage auf einmal gestellt hat.
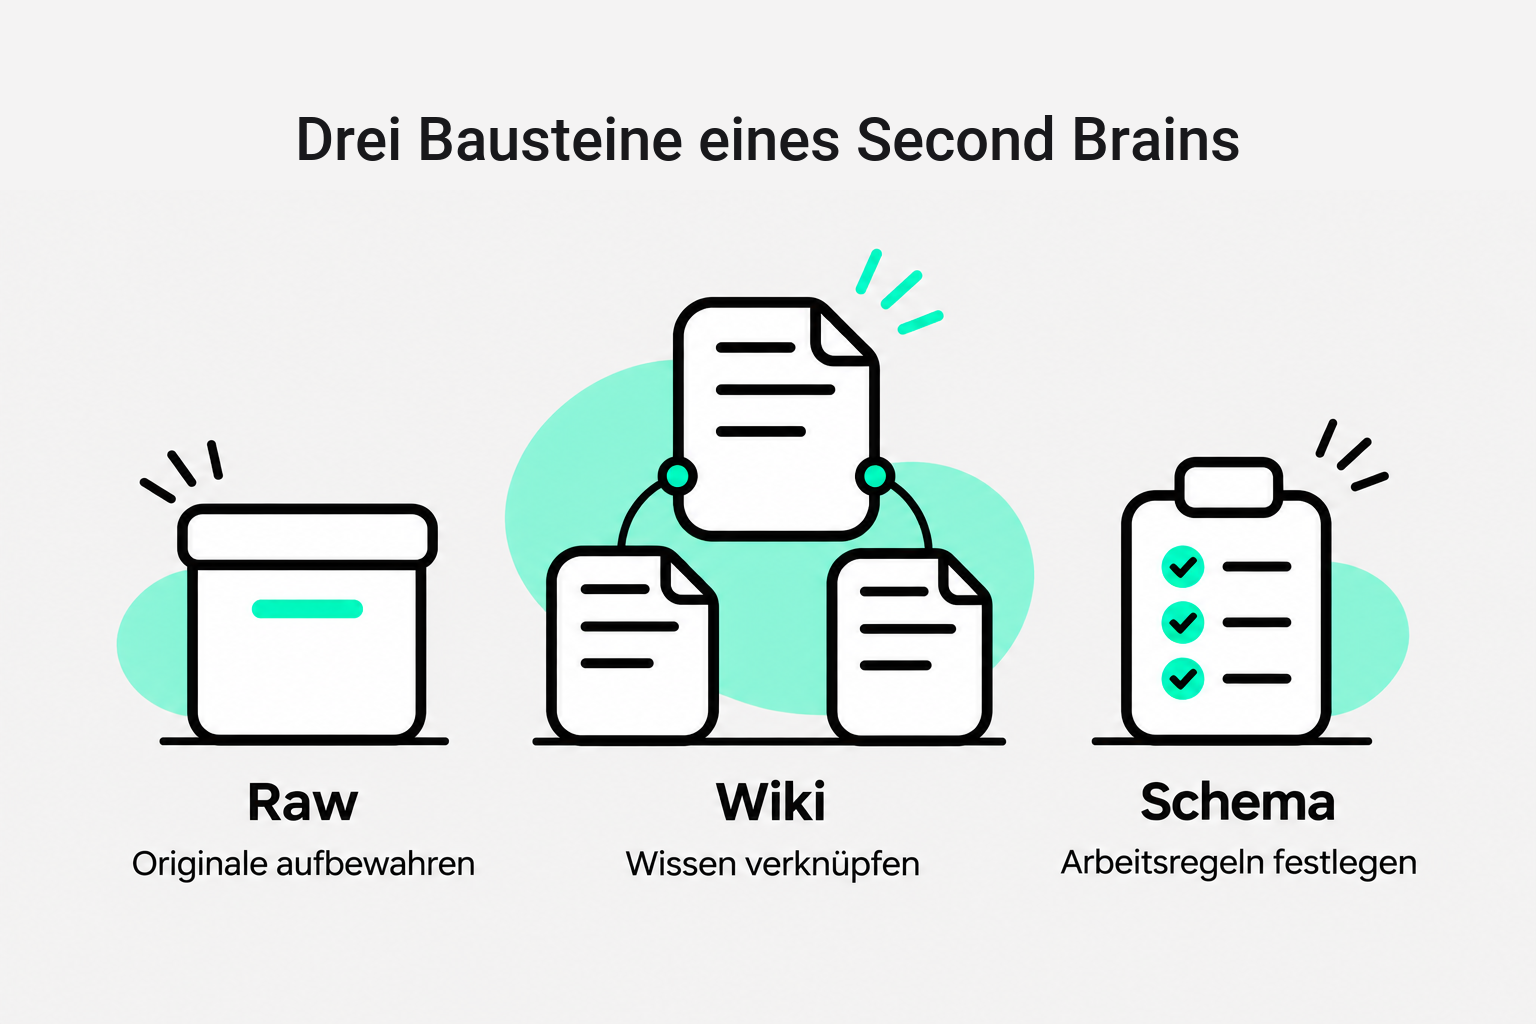
Die Grafik zeigt die drei Bausteine des Ansatzes: „Raw“ steht für die unveränderten Originalquellen. Im „Wiki“ werden daraus Zusammenfassungen und verknüpfte Wissensseiten. Das „Schema“ beschreibt die Arbeitsregeln, etwa in einer AGENTS.md. Diese Funktionen lassen sich unterschiedlich organisieren. Meine eigene Ablage ist aktuell nach Projekten aufgebaut.
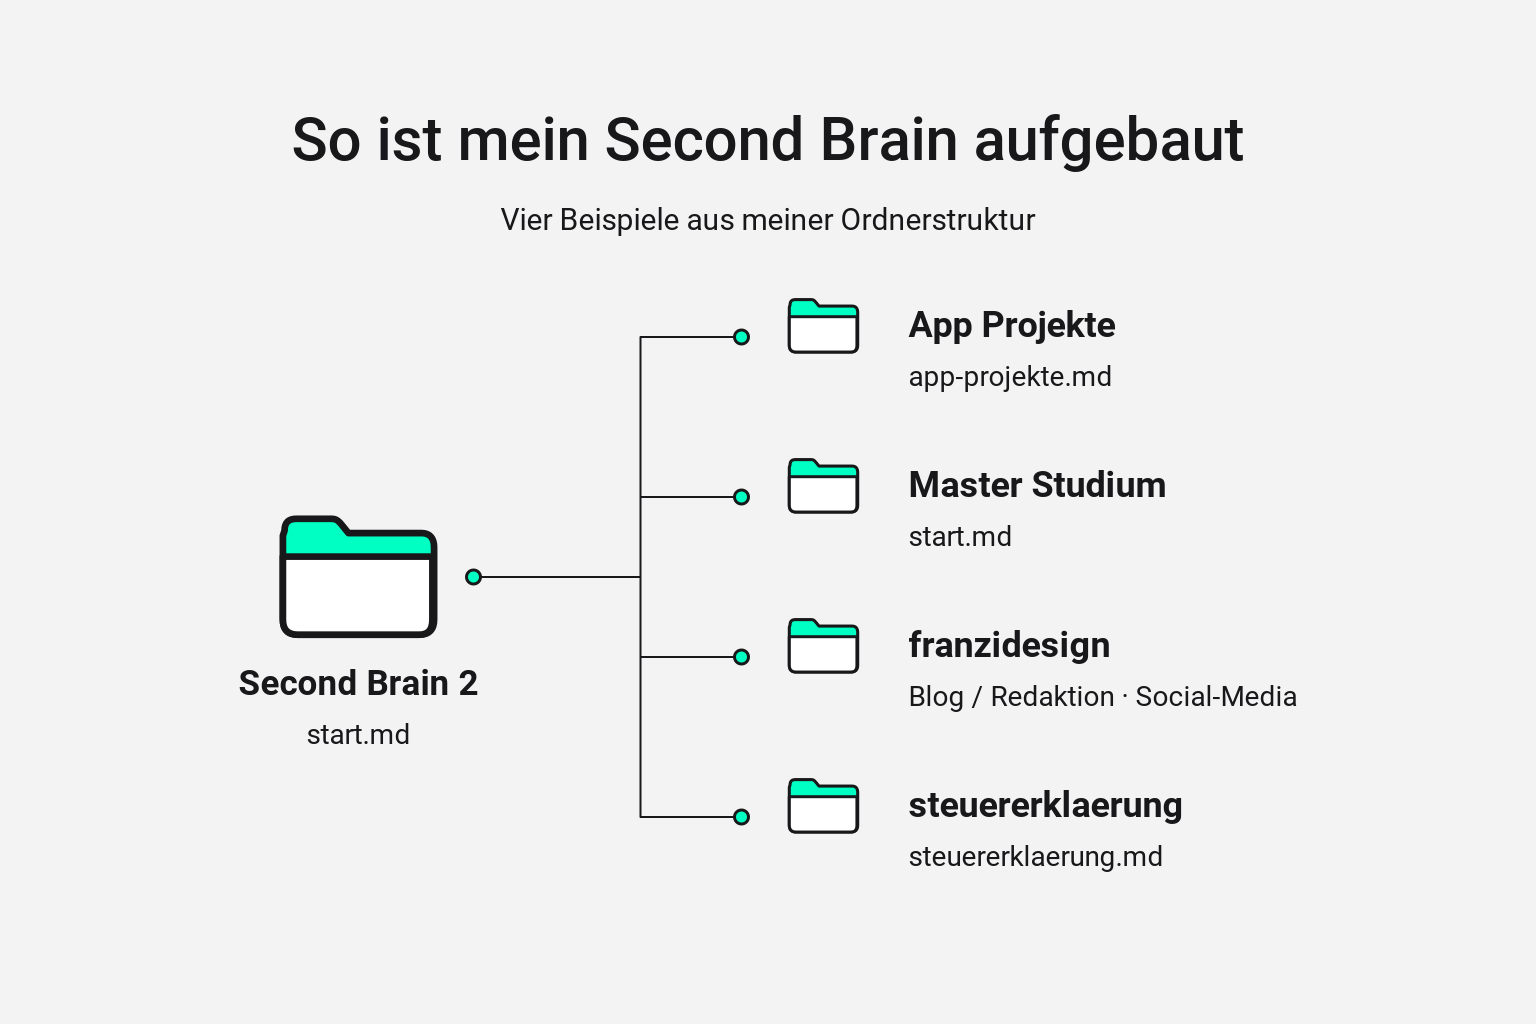
Los ging es mit der Einordnung meiner beiden aktuellen App-Projekte „WirkTakt“ und „Wie war dein Arbeitstag?“. Mit weiteren Bereichen kam die gemeinsame Startseite start.md dazu.
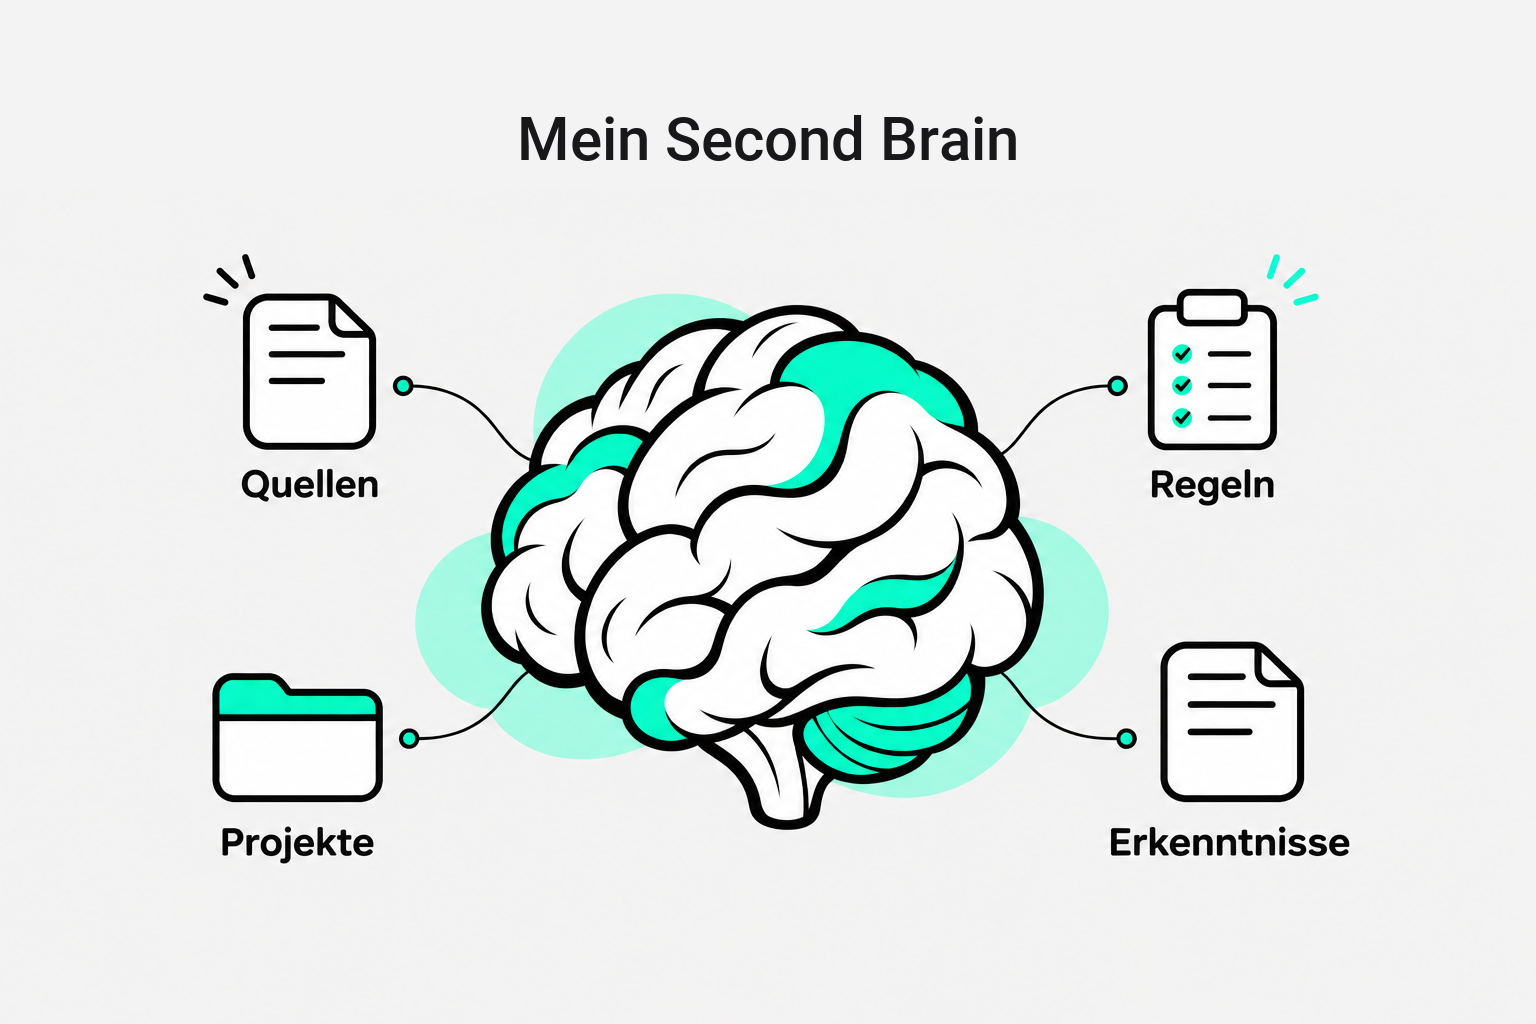
Heute gibt es „franzidesign“ mit den Unterordnern „Blog“ und „Social-Media“. Im Blogbereich liegen die Redaktionsübersicht, das Artikelarchiv und mein Schreibprofil. Die Artikel selbst sind unter „Blog/Artikel“ abgelegt. Meine Steuerunterlagen liegen nach Jahren im Bereich „steuererklaerung“. Die Grafik zeigt vier Beispiele aus dieser Struktur; zum gesamten Brain gehören weitere Bereiche.
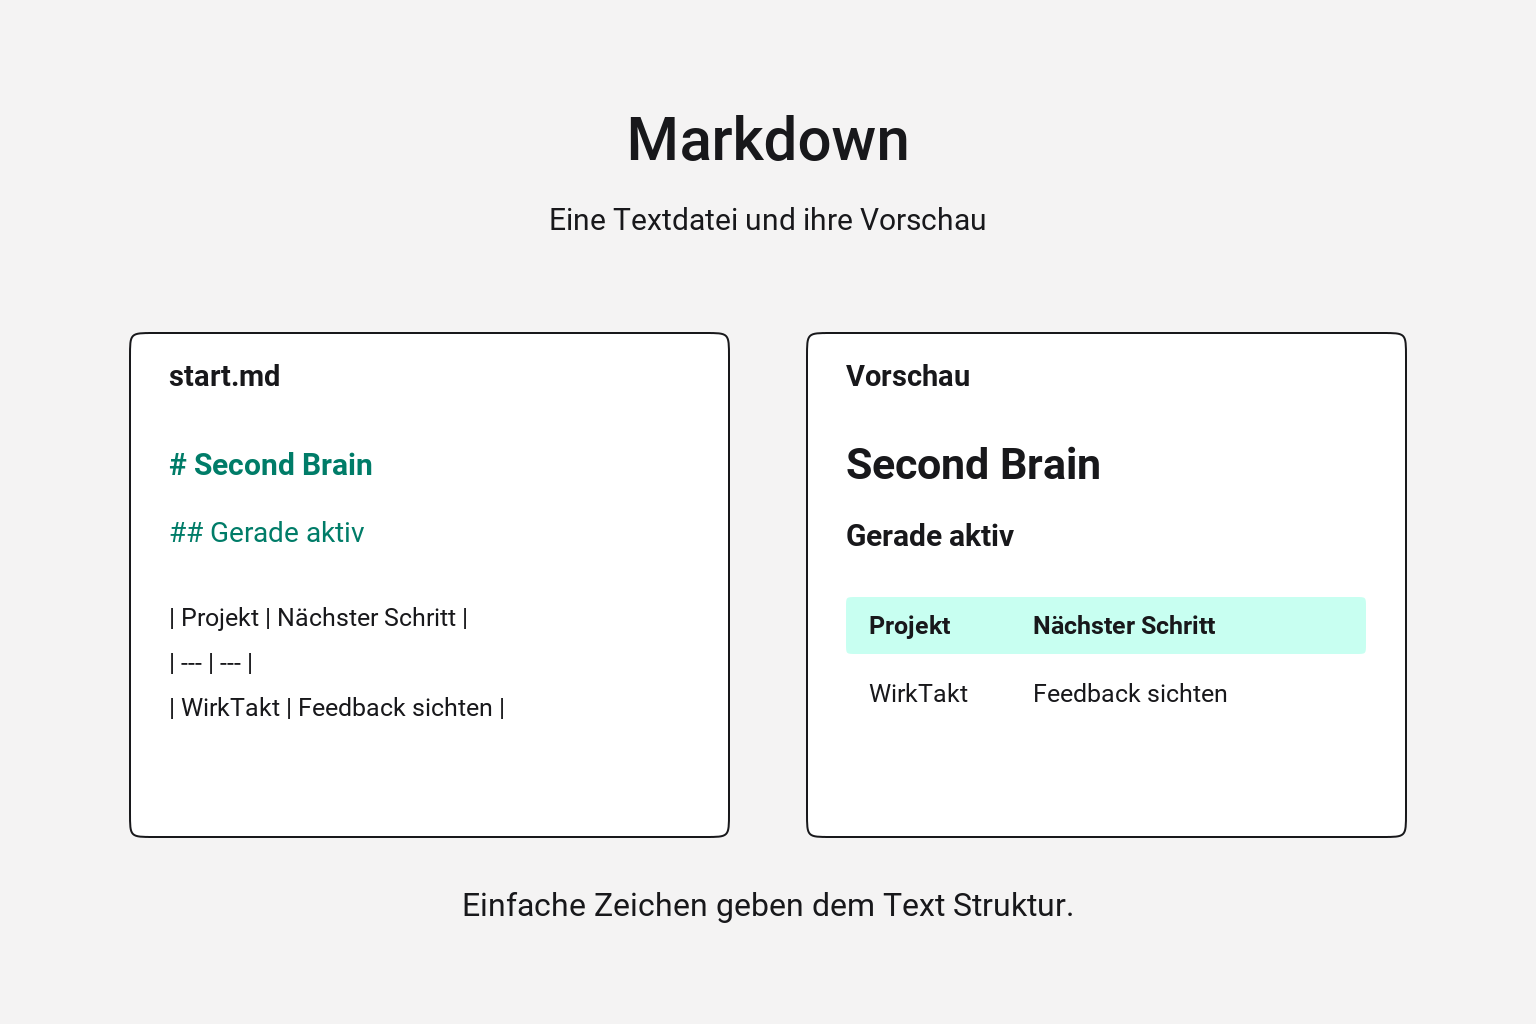
Meine Startseite heißt start.md. Die Endung .md steht für Markdown: eine Textdatei, in der einfache Zeichen die Struktur kennzeichnen. Ein # am Zeilenanfang markiert eine Hauptüberschrift, ## eine weitere Überschriftenebene. Senkrechte Striche und eine Trennzeile bilden die Tabelle im Beispiel. Links ist dieser Text zu sehen, rechts seine formatierte Vorschau. Die Datei lässt sich auch mit einem einfachen Texteditor öffnen.
Wie aus Material verknüpftes Wissen wird
In meinem Blogbereich sind bereits mehrere Seiten verknüpft. Die Redaktionsübersicht führt zum Artikelarchiv mit Titeln, Datum und Original-URLs sowie zum Schreibprofil. Darin sind Themen und Merkmale meines Tons anhand früherer Beiträge festgehalten. So kann ich bei einer neuen Idee nachsehen, was ich dazu schon geschrieben habe. Die Verbindungen bestehen aus Links in den Dateien – die Linien in den Grafiken machen dieses Prinzip sichtbar.
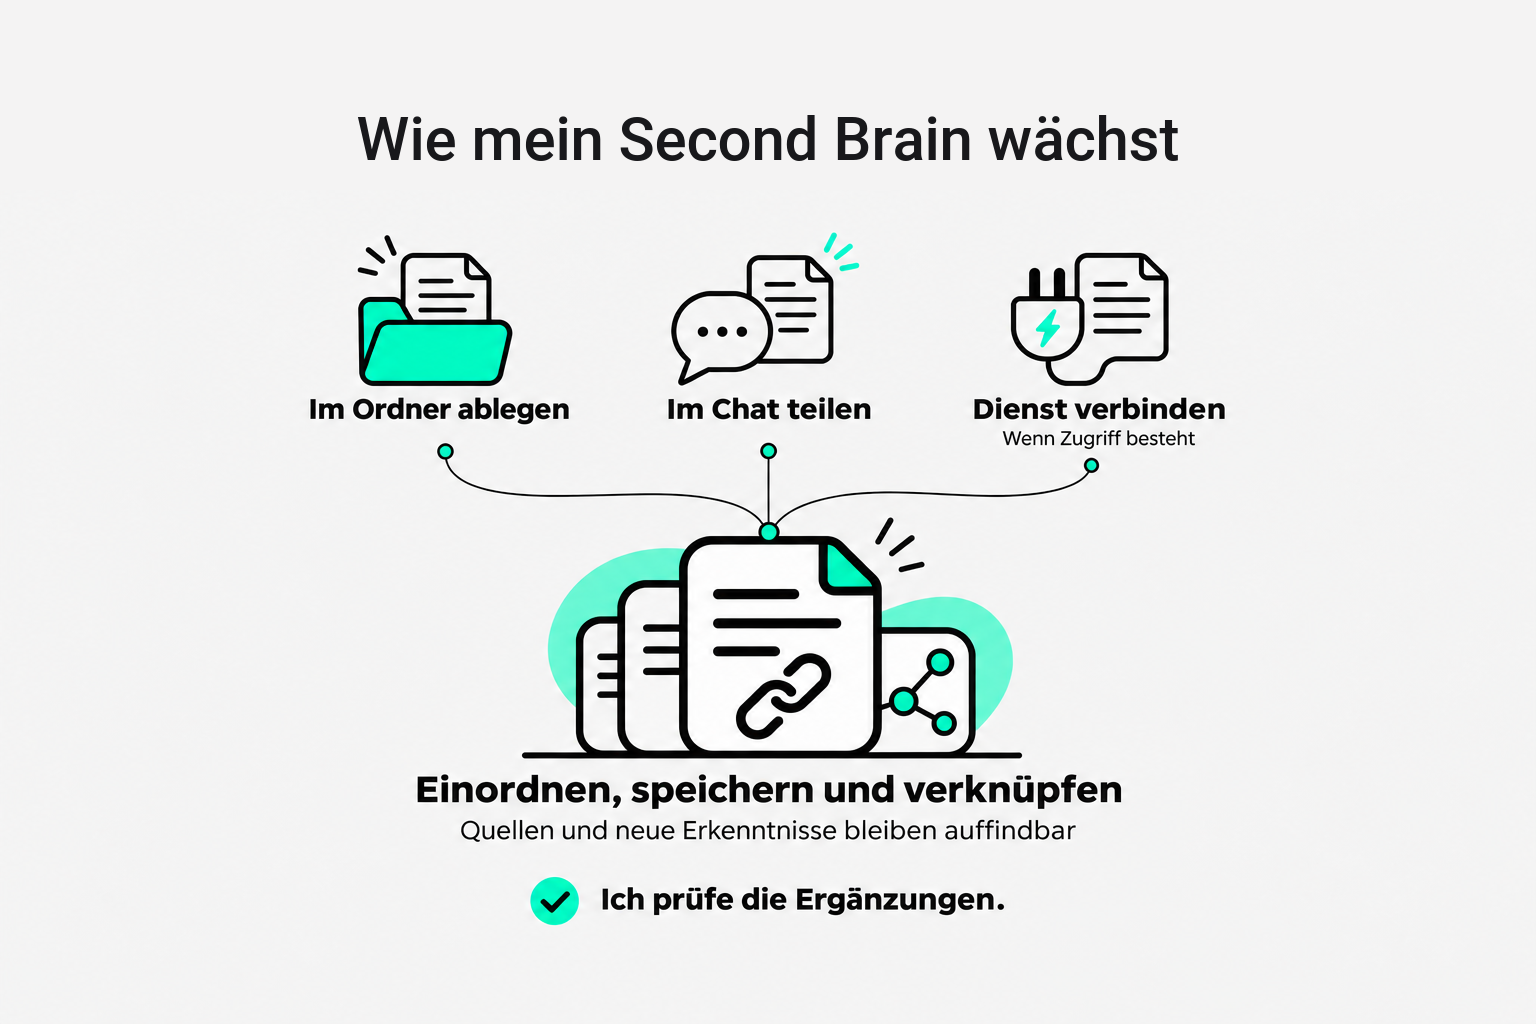
Neues Material kann ich direkt im Arbeitsordner ablegen oder im Chat teilen und sagen, zu welchem Projekt es gehört. Ein verbundener Dienst kann ebenfalls Quellen liefern, wenn der entsprechende Zugriff besteht. Anschließend gebe ich der KI den Auftrag, das Material einzuordnen: die Kernaussagen festhalten, die Quelle vermerken und passende Projektseiten ergänzen. Das Ergebnis kontrolliere ich selbst.
So wächst mein Second Brain mit den Ergebnissen unserer Arbeit. Eine hilfreiche Zusammenfassung oder ein Vergleich kann als eigene Textdatei erhalten bleiben. Links von der Projektübersicht und passenden Notizen machen den Zusammenhang sichtbar. Das zusätzliche Wissen steckt in diesen gespeicherten Ergänzungen, die die KI bei späteren Aufgaben wieder einliest. Ich prüfe, ob sie zur Quelle passen, früheren Aussagen widersprechen oder an einem anderen Ort besser aufgehoben wären.
Zur Pflege gehört für mich auch, die Ablage regelmäßig auf veraltete Aussagen, fehlende Quellen und ins Leere laufende Links prüfen zu lassen. Bei veränderlichen Zahlen brauche ich ein Stand-Datum und einen Verweis auf die Quelle für den aktuellen Wert. Eine regelmäßige automatische Pflege ist ein möglicher nächster Schritt; bisher beauftrage ich die Arbeiten im Gespräch.
Was der KI-Agent dabei übernimmt
Automatisieren bedeutet, einen wiederkehrenden Ablauf nach festgelegten Regeln ausführen zu lassen. Für den regelmäßigen Abgleich meines Blogarchivs bräuchte ich zum Beispiel eine verlässliche Vergleichsliste und einen klaren Prüfauftrag. Diesen Ablauf habe ich bisher als Idee festgehalten.
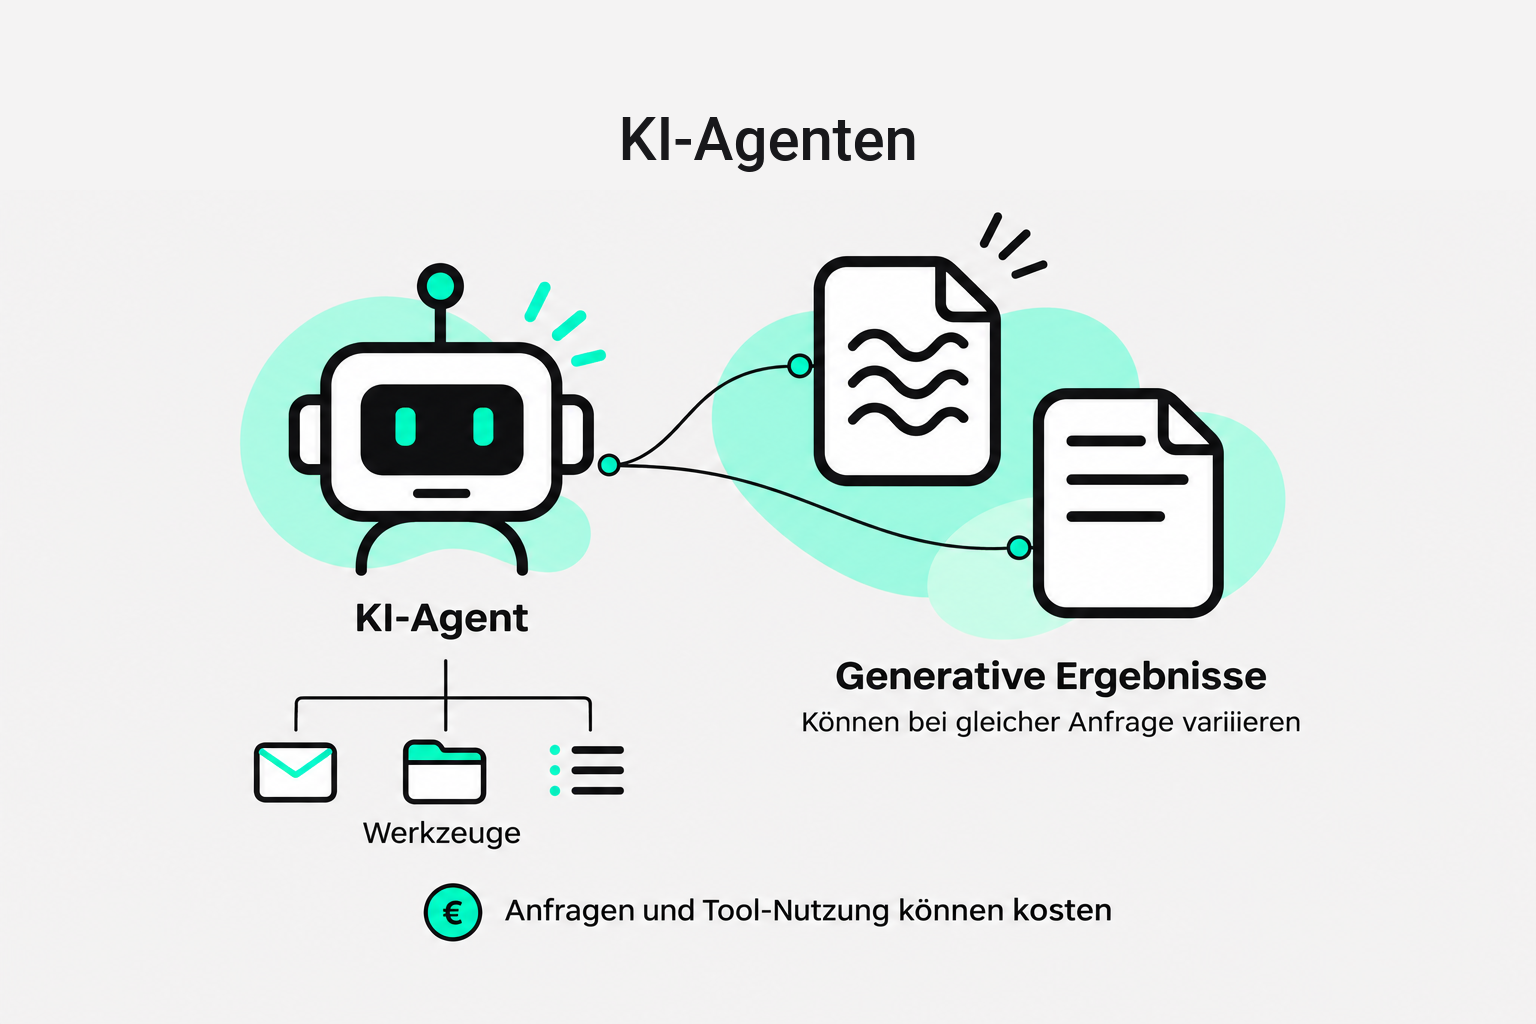
Ein KI-Agent kann innerhalb seines Auftrags entscheiden, welches der verfügbaren Werkzeuge er als Nächstes nutzt. Beim Blogarchiv konnte ChatGPT zum Beispiel zuerst die Ablage prüfen und anschließend die Kategorien meiner Website zum Vergleich heranziehen.
Die vom KI-Modell erzeugten Texte und Bilder können auch bei gleicher Anfrage unterschiedlich ausfallen. Je nach Dienst und Tarif können Modellanfragen, Bildgenerierung oder weitere Werkzeuge Kosten verursachen. Eine eigene Wissensablage hebt Nutzungslimits oder Kosten nicht auf.
Damit die KI mit Dateien arbeiten kann, braucht sie neben dem Sprachmodell eine Software, die Werkzeugaufrufe ausführt und deren Ergebnisse an das Modell zurückgibt. Dieses technische Zusammenspiel wird als „Agent Harness“ bezeichnet. Dazu gehören auch die vorgegebenen Zugriffsrechte und Grenzen der Arbeitsumgebung.
Für mein Second Brain musste ich keinen eigenen Harness entwickeln: Ich nutze die vorhandene Arbeitsumgebung, in der ChatGPT auf die freigegebenen Dateien und Werkzeuge zugreifen kann. Mein Second Brain besteht aus den darin abgelegten Quellen, Notizen und Verknüpfungen. Die AGENTS.md ergänzt Arbeitsregeln; sie ist selbst kein Harness.
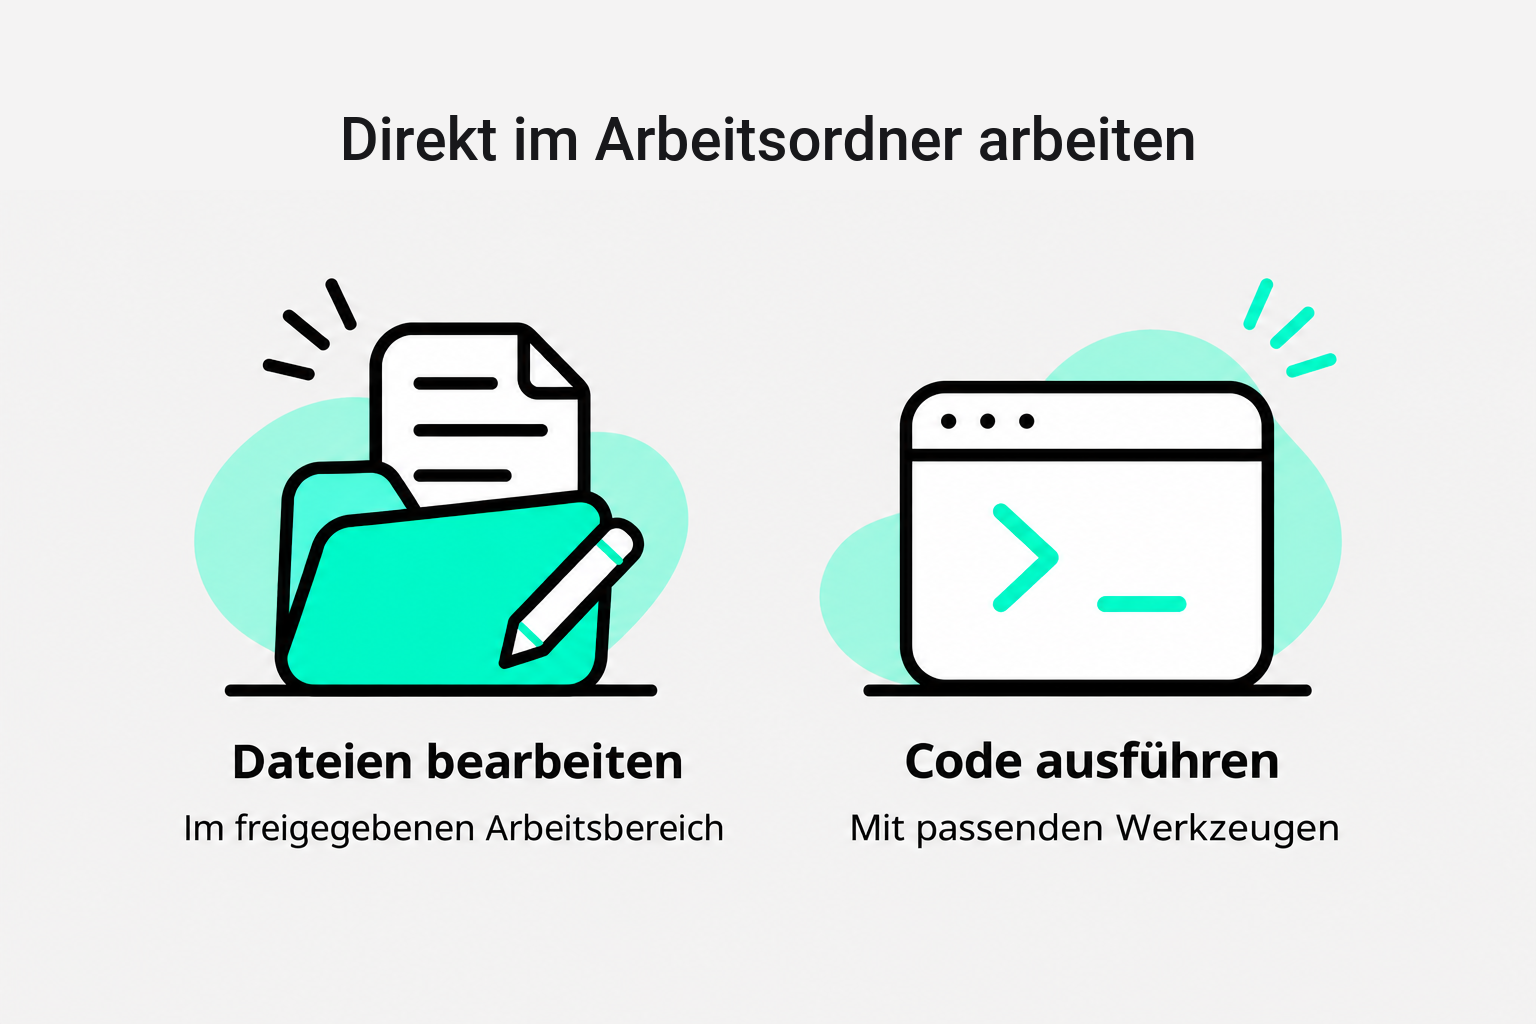
Mit den passenden Werkzeugen und Berechtigungen kann der Agent Dateien bearbeiten und Code ausführen, etwa um eine Dateiliste zu erstellen. Ob die Liste vollständig ist, lässt sich erst im Abgleich mit einer verlässlichen Übersicht beurteilen. Welche Quellen ich dafür bereitstelle und ob das Ergebnis meinen Anforderungen entspricht, bleibt meine Entscheidung.
- Second Brain: Meine gespeicherten Quellen, Notizen und Verknüpfungen.
- KI-Agent: Bearbeitet meinen Auftrag und wählt dafür verfügbare Werkzeuge.
- Harness: verbindet das KI-Modell mit den Werkzeugen und organisiert deren Ausführung.
- AGENTS.md: enthält meine Arbeitsregeln.
Was ich aus der Barcamp-Session mitnehme
Am 19. November 2026 habe ich beim UX-Leadership-Barcamp spontan meinen Mut zusammengenommen und eine Session zu diesem Experiment angeboten. In einer gemeinsamen Session habe ich von meinem Second Brain erzählt und versprochen, diesen Artikel zeitnah zu teilen.
Im Gespräch kam auch die technische Steuerung des Agenten zur Sprache. Für Teams sind dabei gemeinsame Abläufe, Zugriffsrechte und die Prüfung von Ergebnissen wichtig. Eine eigene technische Lösung kann sinnvoll werden, wenn die vorhandenen Werkzeuge diese Anforderungen nicht erfüllen. Für mein persönliches Experiment reicht bisher die vorhandene Arbeitsumgebung. Auch Visual Studio Code, das wir im beruflichen Umfeld nutzen, ist zunächst ein Editor; die KI-Funktionen hängen von den eingebundenen Werkzeugen ab. Mir ging es darum, anzufangen, an eigenen Aufgaben Erfahrungen zu sammeln und andere zum Ausprobieren zu ermutigen.
Dominique Winter hat einen für mich wichtigen Punkt eingebracht: Der Prozess muss klar sein. Welches Wissen möchte ich zugänglich machen? Wie fasse ich vorhandenes Material zusammen? Und wie arbeite ich anschließend mit diesen Zusammenfassungen weiter?
Für meinen Blog lässt sich das konkret beschreiben: Ich stelle das Material bereit, lasse relevante Aussagen mit ihren Quellen zusammenfassen und mit dem passenden Projekt verknüpfen. Danach prüfe ich die Ergänzungen. Der bestätigte Stand wird gespeichert und dient als Ausgangspunkt für den nächsten Beitrag. Für mich gehört es zum Ausprobieren deshalb auch, diesen Ablauf bewusst weiterzuentwickeln. Meinen Rückblick auf das UX-Leadership-Barcamp findet ihr hier: Mein Rückblick auf das UX-Leadership-Barcamp
Mein Fazit
Mein Second Brain hilft mir bisher vor allem, mit vorhandenem Material weiterzuarbeiten. Bei meinem Blogarchiv hat mir die KI bereits Arbeit abgenommen. Diesen Artikel schreibe ich gerade mit dem neuen Brain: Der Entwurf liegt im Blogordner, und ich arbeite mit ChatGPT direkt in der Datei weiter.
Auch die eigens für diesen Beitrag gestalteten Grafiken sind mit KI entstanden. Ich habe Konzepte beschrieben und gesagt, was sie zeigen sollen. Die KI hat daraus Entwürfe erstellt, an denen wir weitergearbeitet haben. Die Screenshots im Beitrag dokumentieren meinen Arbeitsprozess.
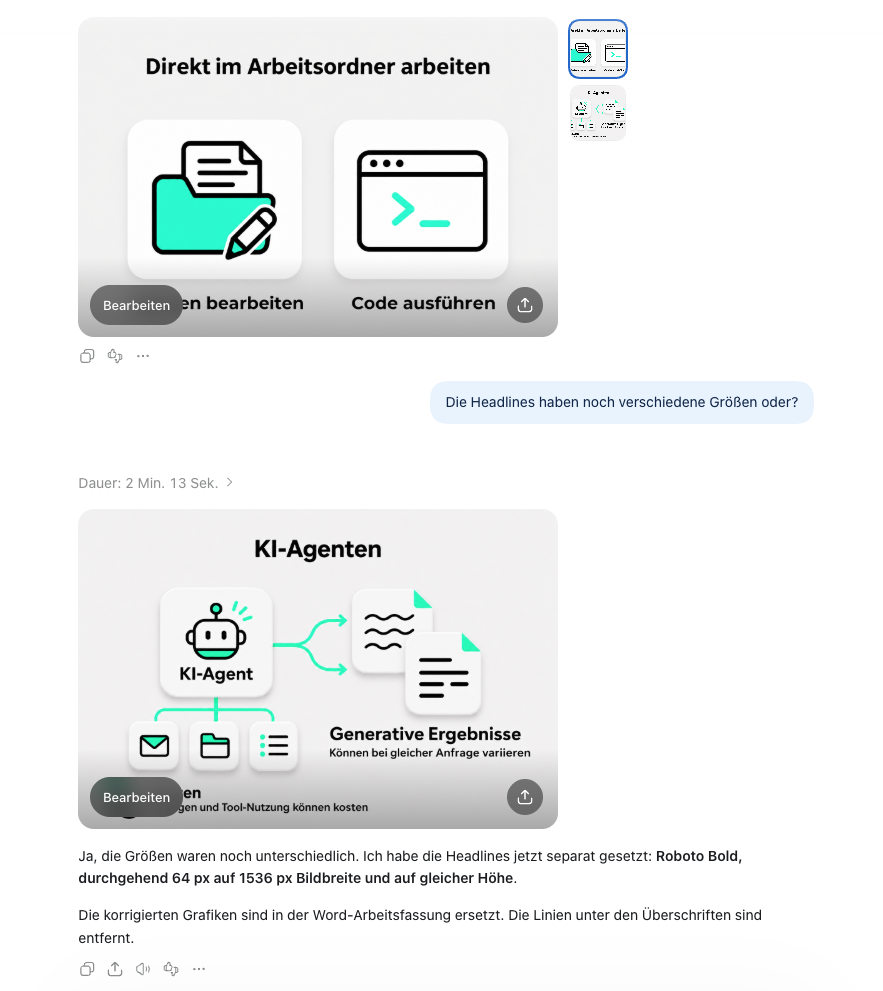
Die Zusammenarbeit erinnert mich manchmal an eine Praktikantin oder einen Praktikanten an meiner Seite: Ich beschreibe die Aufgabe, gebe Orientierung und bekomme eine Umsetzung, an der wir weiterarbeiten können. Je genauer ich weiß, was ich möchte, desto konkreter kann ich Rückmeldung geben. Ob das Ergebnis für meinen Zweck passt, muss ich selbst beurteilen.
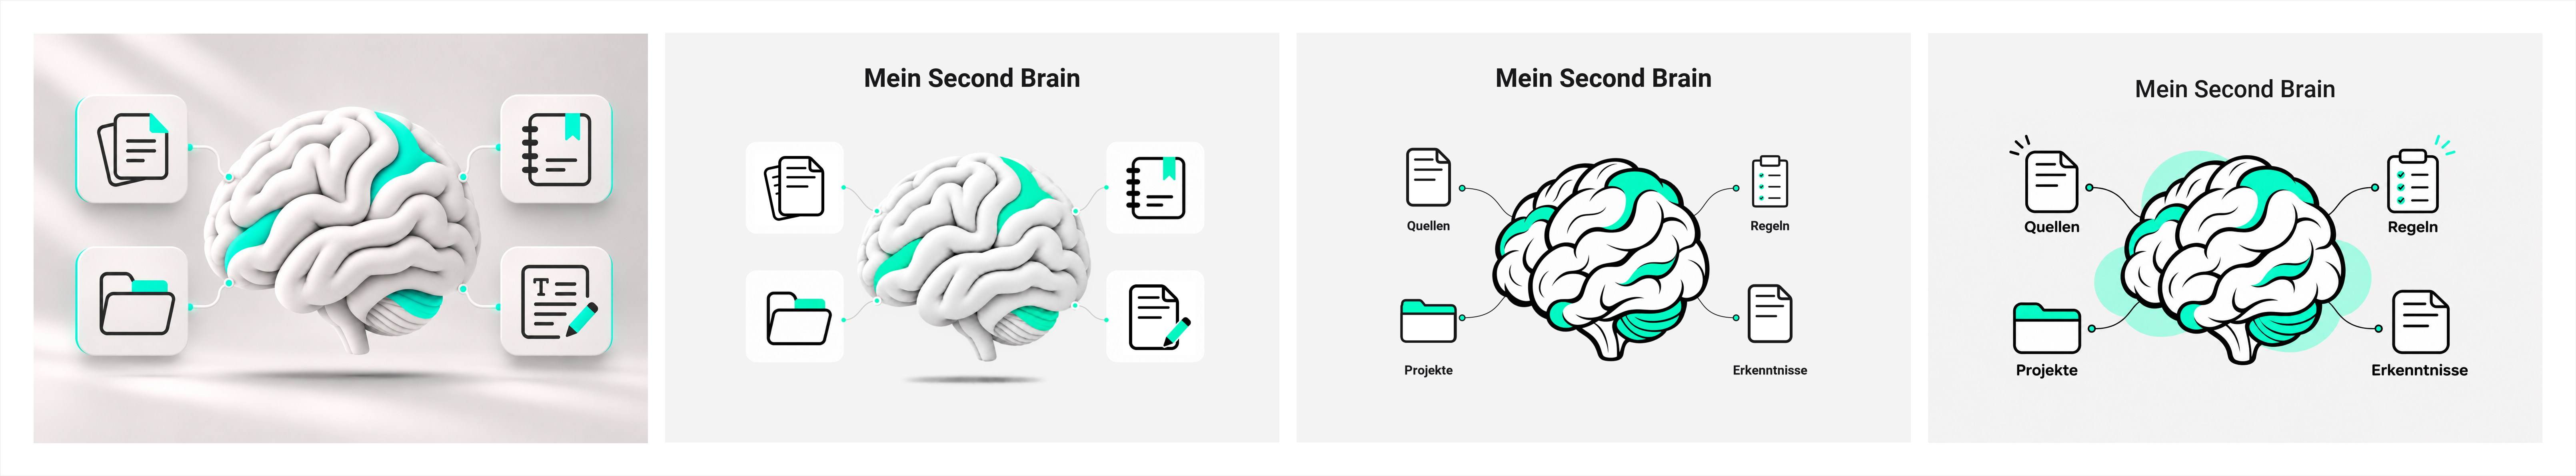
Eine einheitliche Bildsprache braucht weiterhin viel gestalterische Steuerung.
Die Bildfolge unten zeigt die Entwicklung der Bloggrafik: links der erste Entwurf, rechts die freigegebene Fassung. Dazwischen lagen viele Rückmeldungen zu Schriftgrößen, Abständen, Konturen, Farben und Proportionen. Für den einheitlichen franzidesign-Stil habe ich ungefähr drei zusätzliche Stunden in die Überarbeitung der Grafiken investiert. Für mich hat sich diese Arbeit gelohnt.
Nach und nach möchte ich auch meine anderen Projekte im Second Brain zentral verwalten. Wie effizient das langfristig wird, zeigt sich erst im Alltag. Bisher hilft mir das Brain vor allem, an meine Unterlagen, Ideen und Entscheidungen anzuknüpfen. Die gestalterische und inhaltliche Beurteilung bleibt dabei ein wesentlicher Teil meiner Arbeit.
Wie sind eure Erfahrungen?
Habt ihr schon ein eigenes Second Brain aufgebaut?
Ich freue mich auf eure Gedanken auf LinkedIn.
Wenn ihr Fragen habt, schreibt mir gerne!
Die Illustrationen in diesem Beitrag sind mit KI entstanden. Konzepte, gestalterische Vorgaben, Auswahl und Überarbeitung stammen von mir. Die Screenshots zeigen Ausschnitte aus meinem tatsächlichen Arbeitsprozess.
Quellen und weiterführende Links
Jonas Keil – verwendeter Setup-Prompt
Andrej Karpathy – LLM Wiki: das zugrunde liegende Konzept
Anthropic – Claude Code: Dateizugriff und Werkzeuge
Anthropic – Begriffsquelle: Agent Harness (technische Vertiefung)

Lass uns Perspektiven zusammenbringen. ✌️
Du möchtest dich über UX-Strategie, Design Leadership oder inklusive Zusammenarbeit austauschen?
Ich freue mich, von dir zu hören.
Ich freue mich über deine Nachricht.
info@franzidesign.de